摘要
趋势背驰指趋势中离开末个中枢的一段(第二段)相对于连接前两个中枢的一段(第一段)力度减弱,传统上被用来判断趋势的终点。本文在 152 个品种的 1 分钟数据上,用缠论分解得到 5 分钟、30 分钟两个级别的有中枢趋势与类趋势,按“第二段每创一次新极值即构成一个候选停住点、只有最终转折的那一次为正例”的方式构造只含停住点左侧信息的样本,共 10532 个候选。对 36 个度量(含两项对照)逐一计算品种内 AUC,并以品种内置换检验和 Benjamini–Hochberg 校正评估显著性。按样本对加权时,144 项检验中无一在 q<0.05 下显著;按品种等权时有 59 项显著,但几乎全部指向与背驰相反的方向,即第二段越强越可能是终点。进一步检验表明,这一反向关联主要来自样本构造:同一根第二段的多次延伸各计为一个候选,而正例恰为其中延伸最充分的一次。每根第二段只保留一个候选后,反向关联基本消失,剩余零星显著结果的数量与随机预期相当。结论是:在只使用停住点左侧信息、按本文定义取段的条件下,所检验的各类力度度量均不能稳健地区分趋势的终点与中途的延伸。
1 问题
缠论以“背驰”作为趋势终结的判据:在 a+A+b+B+c 的趋势结构中,若 c 段相对 b 段力度减弱,则 c 段的终点可能是趋势的转折点。力度通常以 MACD 柱面积或价格幅度衡量。这一判据在实践中被广泛使用,但其判别力很少在大样本上检验过。困难有三:其一,“力度”缺乏可操作的定义;其二,判断必须只用转折点左侧的信息,否则会把结果混进判据;其三,趋势的每一次延伸在当时都可能被误认为终点,正反例的界定需要事先约定。
本文的目标不是提出一个新的判据,而是在明确的样本构造与统计口径下,检验一组候选度量是否具有判别力。
2 定义
2.1 走势类型
本文沿用如下走势类型定义:盘整只包含一个中枢;趋势至少包含两个同级别中枢,且相邻的反向段互不重叠;本级别无中枢、由三段或五段以上奇数段构成且相邻反向段不重叠者,称为类盘整或类趋势。本文研究两类对象:有中枢的趋势(5 分上涨/下跌、30 分上涨/下跌)与类趋势(类上涨/类下跌),级别均指走势级别,与 K 线周期无关。
2.2 两段的取法
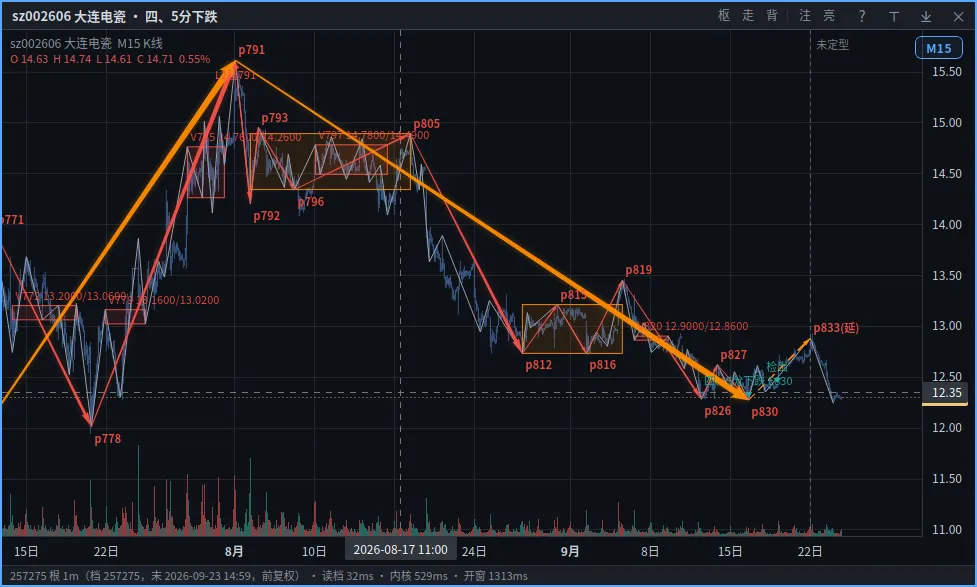
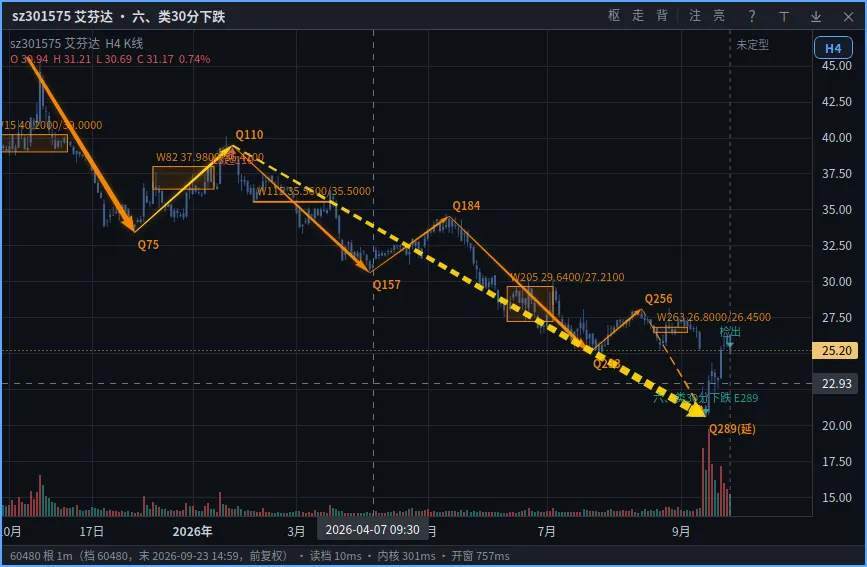
第一段为两个同级别中枢之间的全部 K 线构成的走势,即前一中枢终点至末个中枢起点;第二段为末个中枢右侧至停住点的全部 K 线,即末个中枢终点至当前极值点 E。类趋势没有本级别中枢,以相邻两段同向次级别走势之间的那一段反向次级别走势作为类中枢,第一段须夹在两个类中枢之间。图 1a、图 1b 分别给出两类的实例,均为作者分析工具的截图。
2.3 判定时点与标签
停住点在当时是未知的。本文将第二段每创一次新极值(即走势终点 E 发生改变)的时刻视为一个候选停住点,只用该时刻及以前的信息计算度量。标签由其后的走势决定:若该极值点最终就是这根走势的终点,记为正例;若其后第二段继续延伸,该候选即为背驰的反例。若只是走势起点前移、极值点 E 与方向都不变,不视为转折。同一走势同一极值点只保留首次出现。
3 数据
样本池为 152 个品种:A 股个股 150 只、上证指数(sh000001)与现货黄金(xau_usd),1 分钟 K 线合计约 8796 万根,最早起于 2000 年,截至 2026 年 8 至 9 月。走势分解由作者的缠论分解程序完成(程序版本固定,全部样本出自同一版本),K 线窗口按段点时刻切取。表 1 为四组候选样本的构成。
表 1 候选样本构成
| 组别 | 候选数 | 正例数 | 正例比例 | 品种数 | 走势数 | 第二段根数 | 时间范围 |
| 5 分级·有中枢趋势 | 7050 | 1672 | 23.7% | 149 | 2147 | 2877 | 2000-10-23 至 2026-09-02 |
| 5 分级·类趋势 | 1487 | 282 | 19.0% | 142 | 770 | 850 | 2000-10-09 至 2026-07-30 |
| 30 分级·有中枢趋势 | 1701 | 212 | 12.5% | 113 | 294 | 358 | 2002-01-15 至 2026-07-10 |
| 30 分级·类趋势 | 294 | 28 | 9.5% | 53 | 93 | 102 | 2001-07-06 至 2025-12-23 |
30 分级类趋势只有 294 个候选、28 个正例,统计功效很低,其结果仅作参考。
4 度量
共检验 34 个度量与 2 个对照,度量分为七族:以 1 分钟 K 线为横轴的收益标准差、回归残差与斜率比(K 族);将横轴换为结构单位(5 分级为线段,30 分级为 1 分走势)的同名度量(U 族);1 分钟 K 线 MACD、结构单位 MACD 与单位等长化 MACD(M 族);以中枢高度为尺度的越枢高度与偏离面积(X 族);幅度比(A1);两段等分重采样后的配对回归族(P 族);以及由均值回归模型推出的回头强度、移动均衡线偏离、推进短缺与推进关系断裂(R 族)。对照为第二段长度(C1,结构单位数)与随机数(C0)。各度量的定义见附录 A。
所有度量在计算前约定方向:分数越大,表示第二段相对第一段越弱,即越符合背驰。据此,AUC 大于 0.5 表示度量朝背驰方向区分正反例,小于 0.5 表示相反方向。P6 未预设方向。
5 统计方法
AUC 的三种汇总。 背驰判断针对单个品种的走势序列,不同品种的价格水平与波动差异很大,因此只比较同一品种内的正例与反例。品种内 AUC 为该品种所有“正例—反例”配对中正例得分高于反例得分的比例(得分相同记一半)。本文报告三种汇总:W 为全部品种的正反例配对合并计算,相当于按配对数加权;E 为各品种 AUC 的算术平均,每个品种权重相同;R 在 E 的基础上,先将度量对 ln(第二段长度) 做线性回归并取残差,以扣除第二段延伸程度的影响。
置换检验。 在每个品种内部随机置换正反例标签 1000 次,得到 W、E、R 在无关联假设下的分布,双侧 p 值按“置换统计量离 0.5 的距离不小于观测值”的比例计算。
多重检验。 三种汇总分别对全部(组别 × 度量)的检验做 Benjamini–Hochberg 校正,以 q<0.05 为显著。
稳健性。 对主要度量另做三项检验:每根第二段只保留第一个候选;每根第二段只保留最后一个候选;剔除样本对最多的两个长历史品种(xau_usd、sh000001)。
6 结果
6.1 总体
表 2 按组别汇总了在 q<0.05 下显著的度量个数(不含 C0、C1),并按方向分列。
表 2 显著度量个数(BH q<0.05),按方向分列
| 组别 | 度量数 | W 背驰向 | W 反向 | E 背驰向 | E 反向 | R 背驰向 | R 反向 |
| 5 分级·有中枢趋势 | 34 | 0 | 0 | 0 | 17 | 0 | 4 |
| 5 分级·类趋势 | 34 | 0 | 0 | 1 | 12 | 1 | 6 |
| 30 分级·有中枢趋势 | 34 | 0 | 0 | 1 | 21 | 0 | 7 |
| 30 分级·类趋势 | 34 | 0 | 0 | 0 | 5 | 0 | 2 |
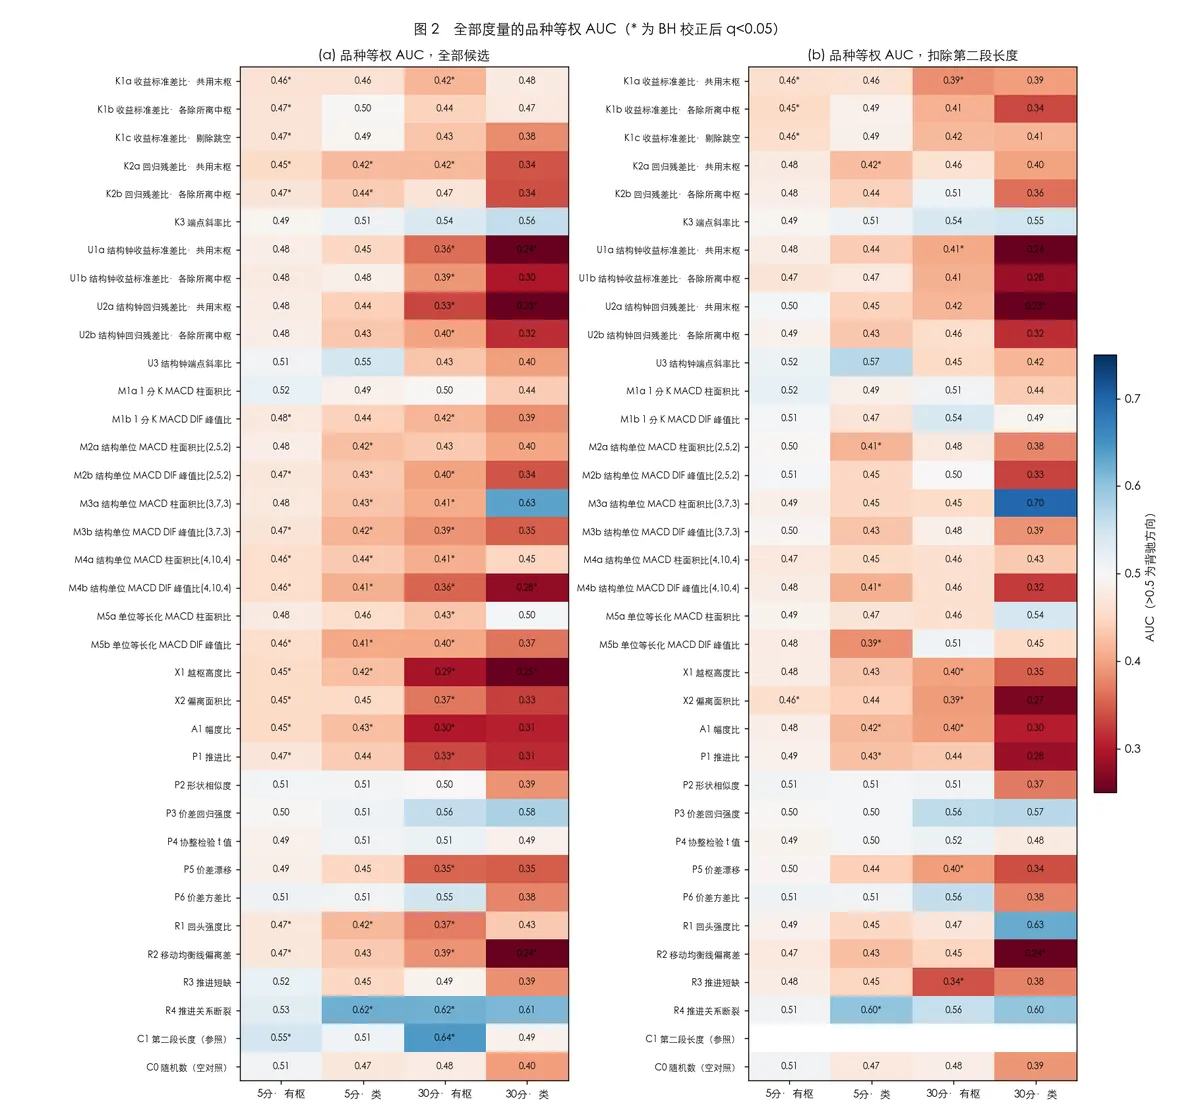
按样本对加权(W)时,144 项检验无一显著。W 的样本对高度集中:四组中正反例配对数最多的 10 个品种分别占全部配对的 80.4%、66.0%、84.6%、96.8%,现货黄金在四组中都位列其中,上证指数在前三组中位列其中;这两个品种的数据长达二十年,走势数远多于一般个股。按品种等权(E)时,情形不同:有 59 项显著,除第二段长度和 R4 外几乎全部小于 0.5,即与背驰方向相反(图 2a)。30 分级有中枢趋势最为明显,A1 幅度比的 E 为 0.300,X1 越枢高度比为 0.293。扣除第二段长度(R)后,仍有 20 项显著,方向同样以反向为主(图 2b)。对照项 C0 在三种汇总下均不显著;C1 第二段长度在 5 分级与 30 分级有中枢趋势中的 E 分别为 0.546 与 0.642,均显著大于 0.5,这说明检验对第二段延伸程度这类结构性关联是敏感的。
6.2 延伸结构检验
样本构造中,同一根第二段在延伸过程中会产生多个候选:较早的延伸幅度较小,标签为反例;最后一次延伸幅度最大,才可能是正例。任何与第二段延伸程度相关的度量都会因此机械地偏向“第二段越强越可能是终点”。按结构单位数回归扣除长度只能去掉一部分这类影响:单位数只是延伸程度的一个代理,不能完全吸收幅度等度量随延伸而发生的变化。更直接的检验是每根第二段只保留一个候选。表 3 列出主要度量的结果。
表 3 主要度量在不同样本子集下的品种等权 AUC(括号内为置换检验 p 值,未校正)
| 组别 | 度量 | 全部候选 | 每根第二段只留首次 | 每根第二段只留末次 | 剔除两个长历史品种 |
| 5 分级·有中枢趋势 | A1 幅度比 | 0.450(0.001) | 0.485(0.421) | 0.477(0.148) | 0.449(0.001) |
| 5 分级·有中枢趋势 | X1 越枢高度比 | 0.452(0.001) | 0.462(0.042) | 0.484(0.294) | 0.450(0.001) |
| 5 分级·有中枢趋势 | K1a 收益标准差比·共用末个中枢 | 0.465(0.005) | 0.484(0.402) | 0.474(0.097) | 0.464(0.001) |
| 5 分级·有中枢趋势 | M3b 结构单位 MACD DIF 峰值比(3,7,3) | 0.468(0.012) | 0.485(0.444) | 0.470(0.062) | 0.467(0.005) |
| 5 分级·有中枢趋势 | R4 推进关系断裂 | 0.527(0.038) | 0.524(0.279) | 0.510(0.568) | 0.528(0.024) |
| 5 分级·有中枢趋势 | P1 推进比 | 0.469(0.011) | 0.484(0.381) | 0.484(0.332) | 0.468(0.009) |
| 5 分级·有中枢趋势 | C1 第二段长度(参照) | 0.546(0.001) | 0.491(0.598) | 0.489(0.476) | 0.547(0.001) |
| 5 分级·有中枢趋势 | C0 随机数(空对照) | 0.508(0.511) | 0.502(0.914) | 0.511(0.474) | 0.508(0.497) |
| 5 分级·类趋势 | A1 幅度比 | 0.425(0.004) | 0.441(0.096) | 0.481(0.514) | 0.423(0.007) |
| 5 分级·类趋势 | X1 越枢高度比 | 0.425(0.004) | 0.409(0.009) | 0.498(0.947) | 0.421(0.006) |
| 5 分级·类趋势 | K1a 收益标准差比·共用末个中枢 | 0.465(0.223) | 0.471(0.395) | 0.475(0.431) | 0.464(0.180) |
| 5 分级·类趋势 | M3b 结构单位 MACD DIF 峰值比(3,7,3) | 0.415(0.005) | 0.419(0.016) | 0.454(0.123) | 0.412(0.001) |
| 5 分级·类趋势 | R4 推进关系断裂 | 0.622(0.001) | 0.556(0.163) | 0.594(0.006) | 0.627(0.001) |
| 5 分级·类趋势 | P1 推进比 | 0.437(0.034) | 0.453(0.155) | 0.479(0.522) | 0.435(0.014) |
| 5 分级·类趋势 | C1 第二段长度(参照) | 0.512(0.667) | 0.487(0.681) | 0.438(0.046) | 0.512(0.650) |
| 5 分级·类趋势 | C0 随机数(空对照) | 0.471(0.289) | 0.482(0.605) | 0.504(0.898) | 0.469(0.269) |
| 30 分级·有中枢趋势 | A1 幅度比 | 0.300(0.001) | 0.599(0.128) | 0.554(0.291) | 0.296(0.001) |
| 30 分级·有中枢趋势 | X1 越枢高度比 | 0.293(0.001) | 0.596(0.134) | 0.465(0.478) | 0.291(0.001) |
| 30 分级·有中枢趋势 | K1a 收益标准差比·共用末个中枢 | 0.418(0.011) | 0.567(0.327) | 0.431(0.167) | 0.417(0.015) |
| 30 分级·有中枢趋势 | M3b 结构单位 MACD DIF 峰值比(3,7,3) | 0.389(0.002) | 0.597(0.156) | 0.582(0.103) | 0.385(0.001) |
| 30 分级·有中枢趋势 | R4 推进关系断裂 | 0.621(0.001) | 0.492(0.918) | 0.537(0.491) | 0.624(0.002) |
| 30 分级·有中枢趋势 | P1 推进比 | 0.335(0.001) | 0.577(0.261) | 0.537(0.457) | 0.331(0.001) |
| 30 分级·有中枢趋势 | C1 第二段长度(参照) | 0.642(0.001) | 0.330(0.011) | 0.548(0.340) | 0.645(0.001) |
| 30 分级·有中枢趋势 | C0 随机数(空对照) | 0.480(0.528) | 0.479(0.780) | 0.544(0.410) | 0.481(0.590) |
| 30 分级·类趋势 | A1 幅度比 | 0.306(0.029) | 0.499(0.989) | 0.499(0.997) | 0.288(0.025) |
| 30 分级·类趋势 | X1 越枢高度比 | 0.254(0.012) | 0.404(0.551) | 0.380(0.361) | 0.237(0.008) |
| 30 分级·类趋势 | K1a 收益标准差比·共用末个中枢 | 0.477(0.823) | 0.505(0.980) | 0.420(0.573) | 0.473(0.793) |
| 30 分级·类趋势 | M3b 结构单位 MACD DIF 峰值比(3,7,3) | 0.351(0.087) | 0.558(0.721) | 0.414(0.527) | 0.341(0.095) |
| 30 分级·类趋势 | R4 推进关系断裂 | 0.613(0.278) | 0.528(0.881) | 0.493(0.966) | 0.625(0.262) |
| 30 分级·类趋势 | P1 推进比 | 0.313(0.054) | 0.521(0.913) | 0.425(0.570) | 0.291(0.042) |
| 30 分级·类趋势 | C1 第二段长度(参照) | 0.490(0.885) | 0.328(0.189) | 0.360(0.279) | 0.491(0.909) |
| 30 分级·类趋势 | C0 随机数(空对照) | 0.395(0.257) | 0.265(0.135) | 0.382(0.379) | 0.383(0.240) |
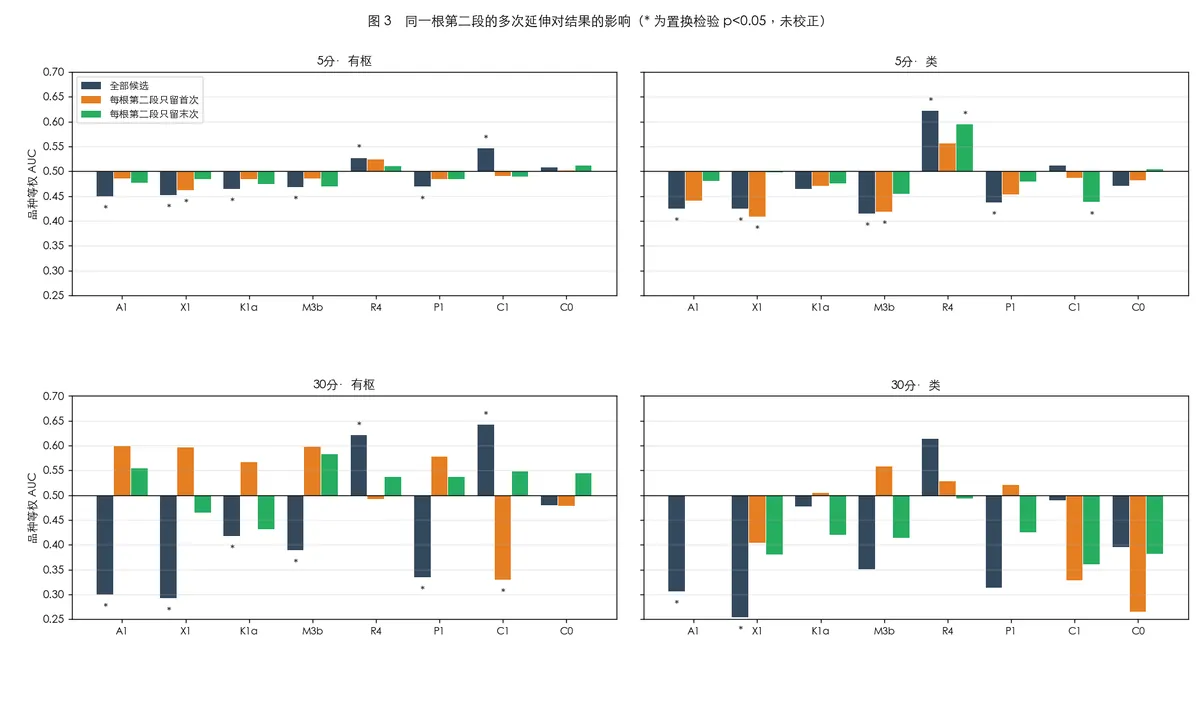
只保留一个候选后,反向关联大多消失。5 分级有中枢趋势中,A1 幅度比的 E 由 0.450 变为 0.485(只留首次)与 0.477(只留末次),均不显著;30 分级有中枢趋势中,A1 由 0.300 变为 0.599 与 0.554,方向甚至翻转,但同样不显著。剔除现货黄金与上证指数后,E 几乎不变,W 则明显向 E 的方向移动:四组度量 W 的中位数由 0.511 / 0.502 / 0.533 / 0.501 变为 0.491 / 0.473 / 0.489 / 0.400,W 小于 0.5 的度量个数由 5 / 16 / 5 / 16 变为 27 / 30 / 22 / 26,但 BH 校正后仍无一显著。前 10 个品种所占配对比例在 5 分级有中枢趋势中由 80.4% 降至 36.7%。可见 W 与 E 的分歧有相当部分来自这两个长历史品种,二者使 W 偏向背驰方向,掩盖了其余品种上与 E 同向的倾向。去除延伸结构后,仍有少数度量在未校正的 p<0.05 下显著,例如 5 分级类趋势中 X1 在只留首次时为 0.409(p=0.009)。只留首次与只留末次两种子集合计 64 项检验,未校正 p<0.05 的有 6 项,其中 2 项为第二段长度 C1 本身;按 5% 计的随机预期约为 3.2 项。这些结果在级别之间、首次与末次之间方向不一致(图 3),不构成稳健证据。
7 讨论
7.1 样本构造的偏差
“每次延伸都是反例、只有最后一次是正例”准确地刻画了背驰判断在当时所面临的问题,但它使同一根第二段在样本中出现多次,且各次之间的差别恰好与度量所衡量的力度同向变化。若不加处理,任何度量只要与第二段已经走了多远相关,就会呈现“第二段越强越可能是终点”的假象。本文在全部候选上观察到的大面积反向结果,主要应作此解释。后续研究若沿用这一构造,应当按第二段分组,或在同一延伸序号内比较。
7.2 加权口径
按样本对加权与按品种等权可以得到方向相反的结论。前者由数据期长、走势多的品种主导,后者对每个品种一视同仁,但会放大候选数少的品种的噪声。两种口径应同时报告;只报其一,容易把少数品种的特性当作普遍规律,或者反之。
7.3 与前期分析的关系
本研究此前做过数轮检验,其中三处设计本文已作修正。第一,早期样本以“极值点其后停住”为入选条件,用到了停住点右侧的信息;本文改为每次创新极值即为候选。第二,早期一轮按时刻切取 K 线窗口时错位了一个段点,窗口整体后移一位,据此得到的路径效率、MACD 等“有效”结论已全部撤回。第三,早期样本只含有中枢的趋势,遗漏了类趋势。本文结果在修正后的设计下取得。
7.4 局限
本文的结论受以下条件约束:分解结果依赖特定版本的分解引擎;样本以 A 股个股为主,只含一个指数与一个商品;只检验了 5 分钟与 30 分钟两个级别;30 分级类趋势样本过少;全部度量都针对第一段与第二段的比较,不涉及停住点右侧,也不涉及跨级别的区间套联判。度量的设计来自作者,未穷尽所有可能的力度定义。
8 结论
在只使用停住点左侧信息、按“两中枢之间”与“末中枢至停住点”取段的条件下,本文检验的收益波动与回归残差(K、U 族)、MACD(M 族)、中枢锚定(X 族)、幅度(A1)、配对回归(P 族)与均值回归(R 族)等七族共 34 个度量,均不能稳健地区分趋势的终点与中途的延伸。全部候选下观察到的“第二段越强越可能是终点”的反向关联,主要是同一根第二段多次延伸所造成的样本构造偏差,在每根第二段只保留一个候选后基本消失。趋势背驰若确有可度量的成分,它不在本文所检验的两段力度对比之中。
附录 A 度量定义
两段比较一律采用同一函数:两者均为正时取第一段与第二段之比的对数,否则取两者之差除以两者绝对值之和。结构单位在 5 分级为线段端点,在 30 分级为 1 分走势端点;价格取对数。
| 编号 | 名称 | 定义 |
| K1a | 收益标准差比·共用末个中枢 | 1 分 K 对数收益标准差,第一段对第二段,分母同为末个中枢内收益标准差(比较时相消) |
| K1b | 收益标准差比·各除所离中枢 | 同 K1a,第一段除以前一中枢、第二段除以末个中枢的收益标准差 |
| K1c | 收益标准差比·剔除跳空 | 同 K1b,剔除隔夜、午休与周末的跨时段收益 |
| K2a | 回归残差比·共用末个中枢 | 对数收盘对 K 线序号回归的残差标准差,分母为末个中枢水平线残差标准差 |
| K2b | 回归残差比·各除所离中枢 | 同 K2a,两段各除所离中枢的水平线残差标准差 |
| K3 | 端点斜率比 | (端点斜率/回归斜率)第一段减第二段,横轴为 K 线序号 |
| U1a | 结构单位版收益标准差比·共用末个中枢 | 同 K1a,横轴改为结构单位(5 分级为线段,30 分级为 1 分走势),价取单位端点 |
| U1b | 结构单位版收益标准差比·各除所离中枢 | 同 K1b 的结构单位版 |
| U2a | 结构单位版回归残差比·共用末个中枢 | 同 K2a 的结构单位版 |
| U2b | 结构单位版回归残差比·各除所离中枢 | 同 K2b 的结构单位版 |
| U3 | 结构单位版端点斜率比 | 同 K3 的结构单位版 |
| M1a | 1 分 K MACD 柱面积比 | MACD(12,26,9) 柱在两段上按方向求和之比 |
| M1b | 1 分 K MACD DIF 峰值比 | 两段上按方向取 DIF 最大值之比 |
| M2a | 结构单位 MACD 柱面积比(2,5,2) | MACD 在结构单位端点价序列上计算,周期以单位计 |
| M2b | 结构单位 MACD DIF 峰值比(2,5,2) | 同上 |
| M3a | 结构单位 MACD 柱面积比(3,7,3) | 同上 |
| M3b | 结构单位 MACD DIF 峰值比(3,7,3) | 同上 |
| M4a | 结构单位 MACD 柱面积比(4,10,4) | 同上 |
| M4b | 结构单位 MACD DIF 峰值比(4,10,4) | 同上 |
| M5a | 单位等长化 MACD 柱面积比 | 每个结构单位内按 K 线等距取 8 点后计算 MACD(24,56,24) |
| M5b | 单位等长化 MACD DIF 峰值比 | 同上 |
| X1 | 越枢高度比 | 段极值越出所离中枢边沿的距离,以该中枢高度为单位,第一段对第二段 |
| X2 | 偏离面积比 | 段内单位端点相对所离中枢中线偏离之和,以中枢高度为单位 |
| A1 | 幅度比 | 两段对数幅度之比(第一段/第二段) |
| P1 | 推进比 | 两段等分重采样 32 点后第二段对第一段回归,取 −β |
| P2 | 形状相似度 | 同上回归,取 −R² |
| P3 | 价差回归强度 | 回归残差(价差)AR(1) 系数 ρ,取 −(1−ρ) |
| P4 | 协整检验 t 值 | 价差 ADF 检验 t 统计量 |
| P5 | 价差漂移 | 价差对步序回归斜率,取负 |
| P6 | 价差方差比 | VR(4),方向未预设 |
| R1 | 回头强度比 | 段内每次回头幅度对回头起点偏离所参照中枢中心的距离作过原点回归,ln(第二段斜率/第一段斜率) |
| R2 | 移动均衡线偏离差 | 两中枢中心连线(横轴为结构单位序号)外推;第一段极值偏离减第二段 E 偏离,各以所参照中枢高度为单位 |
| R3 | 推进短缺 | 按第一段单位推进率预测第二段推进,短缺量除以第一段残差标准差与 √单位数 |
| R4 | 推进关系断裂 | ln(第二段围绕第一段推进率直线的残差标准差 / 第一段残差标准差) |
| C1 | 第二段长度(参照) | 第二段所含结构单位数 |
| C0 | 随机数(空对照) | 均匀分布随机数 |
附录 B 全部检验结果
36 个度量 × 4 组共 144 项检验的逐项结果(含前后半段分拆)从略;表 2 为其按方向的汇总。